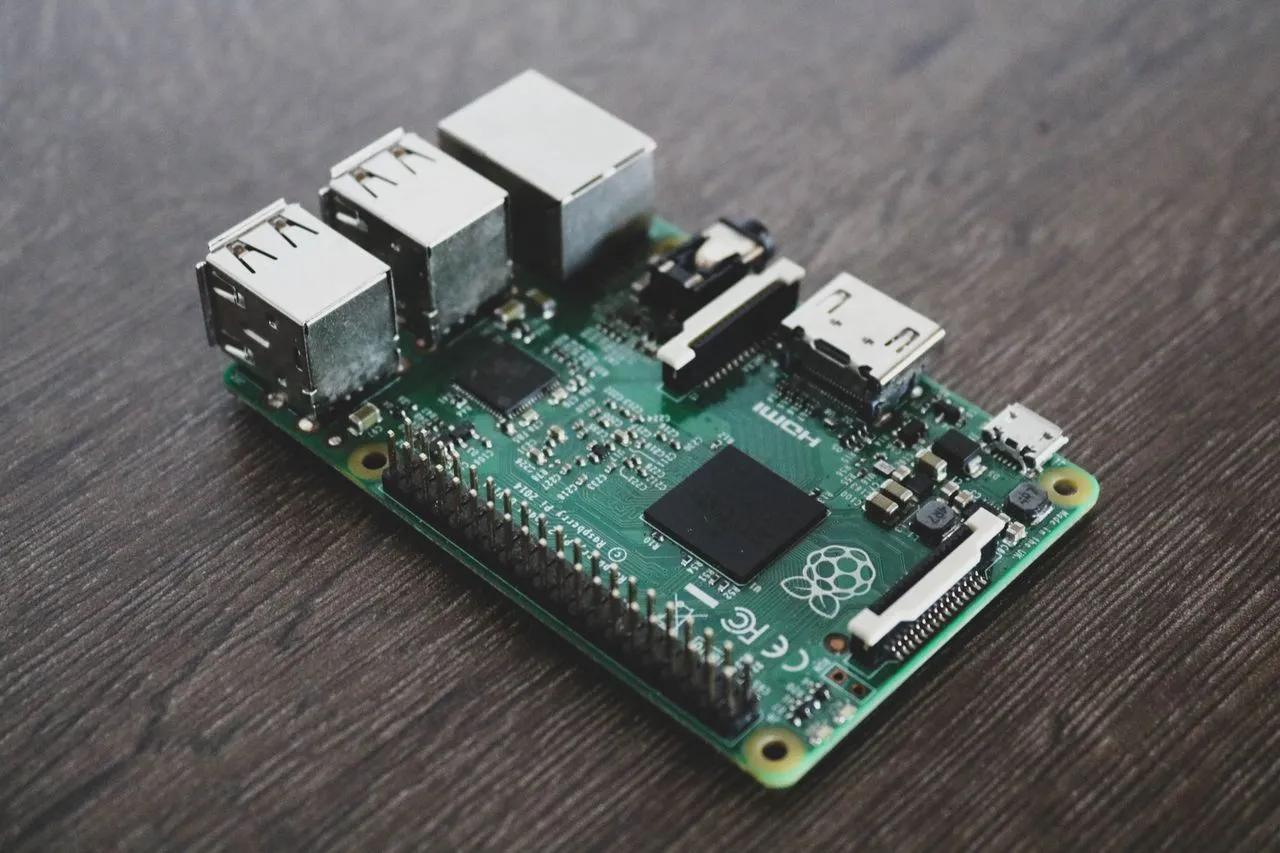
Chi phí thật khi chạy LLM local 24/7: điện, khấu hao, cost/query
Pi 5 chạy inference ăn 7-9 W, khoảng 5.8 kWh mỗi tháng. Công thức tính cost per query và điểm hòa vốn giữa self-host và API cloud cho dev Việt.
Bạn cắm con Raspberry Pi 5 chạy một model nhỏ, để nó online cả ngày cho tiện gọi từ app. Cuối tháng hóa đơn điện không nhảy rõ rệt, nhưng bạn vẫn không trả lời được câu hỏi quan trọng nhất: mỗi query tốn bao nhiêu, và khi nào thì nó rẻ hơn gọi API. Bài này là công thức để tự tính con số đó thay vì đoán.
Board thực sự ăn bao nhiêu watt
Theo phép đo trong bài phân tích của Dev.to, một Pi 5 idle quanh 2.7-3.5 W với OS tối giản. Chạy inference liên tục trên cả bốn core đẩy mức tiêu thụ lên khoảng 7-9 W, cao hơn nữa nếu gắn NVMe hat hoặc USB SSD. Cộng thêm active cooler (0.5-1 W) và accelerator HAT nếu có.
Chi tiết dễ bỏ qua: bộ nguồn USB-C chính hãng 27 W (5V/5A) tồn tại có lý do. Tác giả cảnh báo undervoltage trong một lượt generation dài biểu hiện thành silent error và throttle clock trước khi nó biểu hiện thành reboot — nghĩa là bạn sẽ đổ lỗi cho model trong khi thủ phạm là cục sạc.
Từ watt ra tiền điện
Ở mức trung bình 8 W, chạy 24/7 tương đương khoảng 5.8 kWh mỗi tháng. Tác giả quy ra chỉ tầm 1-2 USD/tháng theo giá điện dân dụng ở thị trường của họ, và lưu ý con số này nhân ba khi bạn thêm board thứ hai hoặc một accelerator.
Đừng bê nguyên con số tiền đó về Việt Nam. Thứ có thể tái sử dụng là 5.8 kWh — hãy nhân nó với đúng bậc thang giá điện mà hộ hoặc văn phòng của bạn đang rơi vào, vì một cụm máy chạy suốt ngày có thể đẩy bạn lên bậc cao hơn và làm mỗi kWh tiếp theo đắt hơn kWh đầu tiên.
Con số quan trọng: cost per query
Công thức trong bài: lấy tiền điện hàng tháng cộng khấu hao phần cứng, rồi chia cho số query thực tế trong tháng. Tác giả tính một bộ Pi 5 hoàn chỉnh khấu hao 3 năm rơi vào khoảng 4-5 USD/tháng — tức phần cứng, chứ không phải điện, mới là khoản chi chính.
Điểm hòa vốn theo tác giả: dưới vài nghìn query mỗi tháng, API cloud với giá vài phần trăm cent mỗi call thường thắng; vượt ngưỡng đó thì local thắng và thắng mãi. Ngưỡng cụ thể phụ thuộc giá điện và độ dài query của bạn, nên nó là một phép tính, không phải một bảng tra.
Nếu bạn định chạy trên GPU thay vì Pi
Một bài hướng dẫn khác cùng chủ đề đi theo hướng máy trạm: Ollama, LM Studio và model trên Hugging Face, với RTX 4090 hoặc RTX 4070 chạy inference ở tốc độ mà tác giả mô tả là so được với gọi API. Hai ràng buộc đáng nhớ từ bài đó: một model 7B cần khoảng 15-20 GB VRAM để nạp và chạy thoải mái, còn chạy CPU-only vẫn được nhưng thời gian phản hồi rơi vào 2-5 giây.
Cùng bài liệt kê khi nào local thắng: xử lý hàng loạt (tóm tắt 1000 tài liệu chạy qua đêm), tính năng cần phản hồi tức thì như autocomplete trong editor, giai đoạn prototype cần lặp không giới hạn rate, dữ liệu nhạy cảm phải nằm lại trong máy, và những khu vực mà giá API đắt. Ngược lại, API vẫn thắng khi bạn cần hiệu năng đầu bảng, phải scale tới hàng nghìn user đồng thời, hoặc cần cam kết uptime.
Việc nên làm tuần này
Cắm một đồng hồ đo điện vào board và ghi lại mức tiêu thụ thật khi inference, đừng dùng số trong bài. Song song, log số query thực tế trong bảy ngày. Có hai con số đó rồi thì phép chia ở trên mới ra kết quả dùng được — và phần lớn người tự host sẽ phát hiện mình đang ở nhánh nào của điểm hòa vốn sớm hơn mình tưởng.
Không spam, hủy đăng ký bất kỳ lúc nào.
Bài viết liên quan
Audit MCP server trên máy dev: 3 lỗi cấu hình cần bịt
17 thg 9, 2026